Investigación
Los modelos abiertos leen bien el texto de una factura y fallan en la foto
En 40 comprobantes ficticios, dos de los tres modelos de texto no se equivocaron en ningún campo. Sobre la imagen escaneada, los modelos de visión fallaron entre 6% y 33% de los campos; 4 reglas automáticas marcaron 26 de las 50 lecturas con algún campo mal (52%), y otras 6 ni siquiera devolvieron un JSON válido, algo que se detecta al leerlas.
Revisado el por Grupo Anta.
Resultado por modelo
El error aparece en la imagen, no en el texto
Los 5 modelos leyeron el mismo prompt y el mismo esquema de 11 campos, con temperatura 0, sobre los mismos 40 comprobantes. Lo que más pesa es el formato: en texto, dos de tres modelos no fallaron; en imagen, el mejor dejó perfectos 57% de los documentos y el otro, 3%.
| Modelo | Pista | Tipo | Serie-número | Fecha | RUC emisor | Razón social | Doc. cliente | Moneda | Gravado | IGV | Exonerado | Total | JSON válido | Doc. perfectos |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Llama 3.3 70B (fp8 fast) | Texto | 100% | 100% | 100% | 100% | 100% | 100% | 100% | 100% | 100% | 100% | 100% | 100% | 100% |
| Mistral Small 3.1 24B | Texto | 100% | 100% | 100% | 100% | 100% | 100% | 100% | 100% | 100% | 100% | 100% | 100% | 100% |
| gpt-oss-120b | Texto | 78% | 78% | 78% | 78% | 78% | 78% | 78% | 78% | 78% | 78% | 78% | 78% | 78% |
| Llama 4 Scout 17B (visión) | Visión | 100% | 88% | 100% | 93% | 93% | 95% | 100% | 88% | 95% | 88% | 98% | 100% | 57% |
| Llama 3.2 11B Vision | Visión | 85% | 85% | 60% | 38% | 43% | 83% | 85% | 75% | 63% | 33% | 85% | 85% | 3% |
Escenario ilustrativo con datos ficticios. Corrida real del 22/09/2026 sobre Cloudflare Workers AI.
gpt-oss-120b es la excepción en la pista de texto: es un modelo de razonamiento, y en 9 de 40 documentos su cadena de razonamiento agotó el presupuesto de tokens antes de escribir el JSON. Mismo prompt, mismo límite de tokens que los demás — no se le dio ventaja ni desventaja.
Costo y velocidad
Llama 3.2 11B Vision es el modelo de visión más barato, y también el que más se equivoca
Costo por 1.000 documentos calculado con el precio verificado de Cloudflare (USD por millón de tokens) sobre los tokens reales que devolvió cada llamada, no una estimación. Latencia p50/p95 de las 200 llamadas de esta corrida.
| Modelo | Pista | US$/M entrada | US$/M salida | Costo / 1.000 docs | Latencia p50 | Latencia p95 |
|---|---|---|---|---|---|---|
| Llama 3.3 70B (fp8 fast) | Texto | US$ 0.293 | US$ 2.253 | US$ 0.49 | 2.6 s | 3.8 s |
| Mistral Small 3.1 24B | Texto | US$ 0.351 | US$ 0.555 | US$ 0.34 | 5.2 s | 7.3 s |
| gpt-oss-120b | Texto | US$ 0.350 | US$ 0.750 | US$ 0.59 | 9.8 s | 15.6 s |
| Llama 4 Scout 17B (visión) | Visión | US$ 0.270 | US$ 0.850 | US$ 0.47 | 3.4 s | 3.8 s |
| Llama 3.2 11B Vision | Visión | US$ 0.049 | US$ 0.676 | US$ 0.24 | 4.3 s | 5.7 s |
La validación determinística
Las reglas atrapan más de la mitad de los errores de la imagen; el resto necesita una persona
RUC con dígito verificador (módulo 11), IGV igual al 18% del gravado, la suma que tiene que cerrar contra el total y el formato de serie-número: cuatro chequeos sin modelo, corridos sobre lo que cada modelo devolvió.
| Modelo | Pista | Sin JSON válido | Con un campo mal | Atrapados por una regla | Tasa de captura |
|---|---|---|---|---|---|
| Llama 3.3 70B (fp8 fast) | Texto | 0 | 0 / 40 | 0 | sin errores |
| Mistral Small 3.1 24B | Texto | 0 | 0 / 40 | 0 | sin errores |
| gpt-oss-120b | Texto | 9 | 0 / 40 | 0 | sin errores |
| Llama 4 Scout 17B (visión) | Visión | 0 | 17 / 40 | 10 | 59% |
| Llama 3.2 11B Vision | Visión | 6 | 33 / 40 | 16 | 48% |
| Los 2 modelos de visión, combinados | Visión | 6 | 50 / 80 | 26 | 52% |
De las 50 lecturas de imagen que devolvieron un JSON válido con algún campo mal, las reglas marcaron 26: 52%. Las otras 24 tenían mal un campo que las reglas no detectan: sobre todo el exonerado, la razón social y un RUC de emisor que en realidad era el del cliente —válido, así que pasa el dígito verificador—. Otras 6 lecturas no devolvieron un JSON válido: eso se detecta al leerlas, sin regla.
Un documento, cinco lecturas
Un dígito de RUC mal leído se atrapa; un documento confundido, solo a medias
El mismo comprobante ficticio —una boleta con una línea exonerada—, leído por los 5 modelos. Lo que cada uno devolvió, lo que debía decir, y qué regla lo marcó.
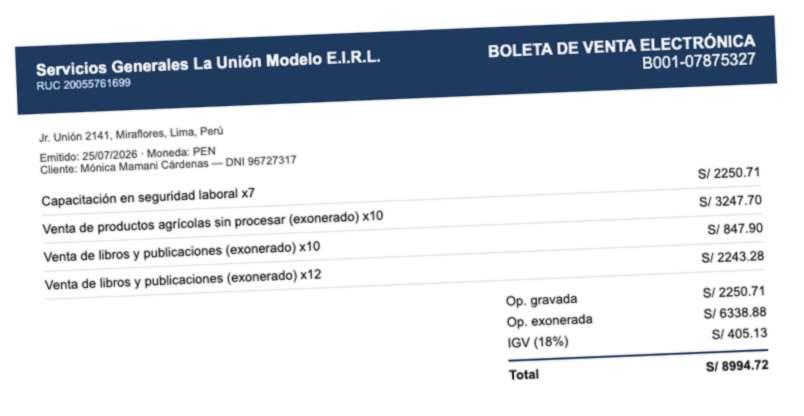
- Tipo
- BOLETA DE VENTA ELECTRÓNICA
- Serie-número
- B001-07875327
- Fecha
- 2026-07-25
- RUC emisor
- 20055761699
- Razón social
- Servicios Generales La Unión Modelo E.I.R.L.
- Doc. cliente
- DNI 96727317
- Moneda
- PEN
- Gravado
- 2250.71
- IGV
- 405.13
- Exonerado
- 6338.88
- Total
- 8994.72
| Modelo | Pista | Campos correctos | Campo(s) mal leído(s) | Regla que lo marcó |
|---|---|---|---|---|
| Llama 3.3 70B (fp8 fast) | Texto | 11 / 11 | ninguno | ninguna |
| Llama 4 Scout 17B (visión) | Visión | 10 / 11 | RUC emisor | RUC no valida |
| Llama 3.2 11B Vision | Visión | 7 / 11 | RUC emisor, Razón social, IGV, Exonerado | RUC no valida, IGV no cuadra (18% del gravado), La suma no cierra con el total |
| Mistral Small 3.1 24B | Texto | 11 / 11 | ninguno | ninguna |
| gpt-oss-120b | Texto | JSON inválido | Tipo, Serie-número, Fecha, RUC emisor, Razón social, Doc. cliente, Moneda, Gravado, IGV, Exonerado, Total | no_parseo |
Escenario ilustrativo con datos ficticios.
Metodología
Cómo se hizo esta medición, y qué no cubre
Ver la metodología completa
Qué se generó
- 40 comprobantes ficticios: 20 facturas y 20 boletas, en 4 plantillas visuales distintas (recuadro clásico, banda moderna, ticket térmico angosto, dos columnas con logo y QR).
- 6 documentos en USD, 9 con al menos una línea exonerada del IGV.
- El RUC del emisor lleva dígito verificador válido por el algoritmo módulo 11 público (el mismo que usan los validadores del ecosistema de facturación electrónica peruana): la empresa es inventada, pero el RUC pasa la fórmula.
- Empresas y personas 100% inventadas (bancos de nombres genéricos combinados al azar); ninguna corresponde a una entidad real.
Las dos pistas
- «PDF con texto»: el texto tal como lo entregaría un lector de PDF, derivado del HTML de cada comprobante con un extractor propio (no una transcripción manual aparte) → a los 3 modelos de texto.
- «Escaneado»: el mismo HTML renderizado a PNG con Chrome headless y degradado con Pillow —rotación de hasta 3°, desenfoque leve, doble compresión JPEG de baja calidad— → a los 2 modelos de visión.
Los modelos
- Mismo system prompt y mismo esquema de 11 campos para los 5 modelos, temperatura 0: la comparación es sobre el modelo, no sobre el prompt.
- 3 modelos de texto y 2 de visión de Cloudflare Workers AI (tabla arriba). Quedaron afuera un 4º modelo de texto (con 3 alcanza para el hallazgo) y un 3er modelo de visión cuya ficha no confirma soporte de imagen.
- Sin modelos cerrados (Claude, GPT, Gemini): esta corrida no sirve para compararlos con los abiertos.
Cómo se normalizó antes de comparar
- Números: acepta separador de miles y decimal en cualquier orden, símbolo de moneda pegado o no; tolerancia de 0,02 contra la verdad de campo.
- Fechas: acepta AAAA-MM-DD, DD/MM/AAAA y "DD de mes de AAAA"; se comparan ya convertidas a un mismo formato.
- Texto (razón social, nombre): mayúsculas y sin puntuación antes de comparar, para no penalizar "S.A.C." contra "SAC".
- RUC y documento del cliente: se comparan solo los dígitos, sin espacios ni guiones.
Límites de esta medición
- Corregido el 23/09/2026: la primera versión contaba las respuestas sin JSON válido como errores atrapados por las reglas, y publicaba 57% en imagen y 100% en gpt-oss-120b. Ahora se cuentan aparte, porque se detectan al leerlas; con las reglas solas, la captura en imagen es 52%. Las corridas son las mismas; cambió el conteo.
- Dataset 100% sintético y de 40 documentos: alcanza para comparar modelos entre sí, no para certificar una tasa de error en producción.
- Solo modelos abiertos de Cloudflare Workers AI; los resultados no se extienden a otros proveedores.
- Corrida el 22/09/2026: 200 llamadas, US$ 0.0849 de gasto real. Los precios de Workers AI y el comportamiento de los modelos pueden cambiar.
Lo que se pregunta después de ver dónde falla un modelo
- ¿Cómo leer facturas y documentos automáticamente?
Esto es la medición; aquí está cómo se arma el proceso completo, con quién revisa lo dudoso. Guía
- ¿Cómo paso los XML de mis comprobantes electrónicos a Excel?
Si tu proveedor ya manda el XML de SUNAT, no hace falta leer nada con un modelo: los datos ya vienen en campos. Herramienta gratuita
- ¿Cuánto cuesta implementar IA en una empresa?
Este benchmark da el costo de leer; la guía de costo explica qué más se paga en un proceso completo. Guía
- La automatización de un proceso concreto, con lo dudoso derivado a una persona
La regla que valida aquí es el mismo patrón que usamos para automatizar un proceso completo. Lo que construimos
¿Tu proceso de facturas depende de que alguien las lea a mano?
Contamos qué parte se puede leer con un modelo, qué regla la comprueba, y qué queda para una persona.